Nem, az LLM-ek nem utánozzák az embert!
Csábító azt gondolni, hogy mivel az LLM-eket az emberi szöveg modellezésére tanítják, a kimenetük megkülönböztethetetlenné válik az emberi írástól. A valóságban azonban az LLM-ek nem csupán megközelítik az emberi szöveget: utótanítással (post-training) olyan segítőkész asszisztensekké alakítják őket, amelyek követik az utasításokat, ez pedig egy szűk tartományra korlátozza az írásukat, amely felismerhető marad.
 Kiss Mihály
Vannak, akik úgy gondolják, hogy az AI-detektálás nem lehetséges, mivel az LLM-eket arra tanítják, hogy utánozzák az emberi szöveget, ez azonban nem így van. Valójában az LLM-ek kifejezetten más módon írnak, mint az emberek, és éppen ez teszi lehetővé az AI-detektálást.
Ennek különböző változatait gyakran halljuk:
„Az LLM-ek az emberi írás eloszlásából mintavételeznek; ezért nem lehet felismerni az LLM által generált szöveget, mivel az LLM tanítási eloszlása emberi.”
„Az LLM-eket arra tanítják, hogy úgy írjanak, mint az emberek, ezért ha jól végzik a dolgukat, az AI által írt szöveg minden detektort felülmúl.”
Első pillantásra ezek az érvek megalapozottnak tűnnek, azonban nem veszik figyelembe, hogy a modern LLM-ek összetett rendszerek. A modern LLM-eket sokkal többre tanítják annál, mint hogy egyszerűen az emberi szövegeloszlást kövessék. Ebben a blogbejegyzésben azt vizsgáljuk meg, hogy a modern LLM-ek, például a ChatGPT, a Claude és a Gemini miért és hol térnek el az emberi szövegeloszlástól, valamint mi adja azt az egyedi stílust és hangot, amely lehetővé teszi az általuk írt szövegek felismerését.
Kezdetben: a következő token előrejelzése
A nyelvi modellek története a szövegkiegészítő modellekkel kezdődött. Ezek a korai nyelvi modellek egyszerűen működtek: nagy mennyiségű szöveges adatból megtanulták, hogy a szavak jellemzően hogyan követik egymást. Ezután a felhasználó megadott a szövegkiegészítő modellnek néhány kezdő szót, a modell pedig ezek alapján megjósolta a legvalószínűbb következő szót.
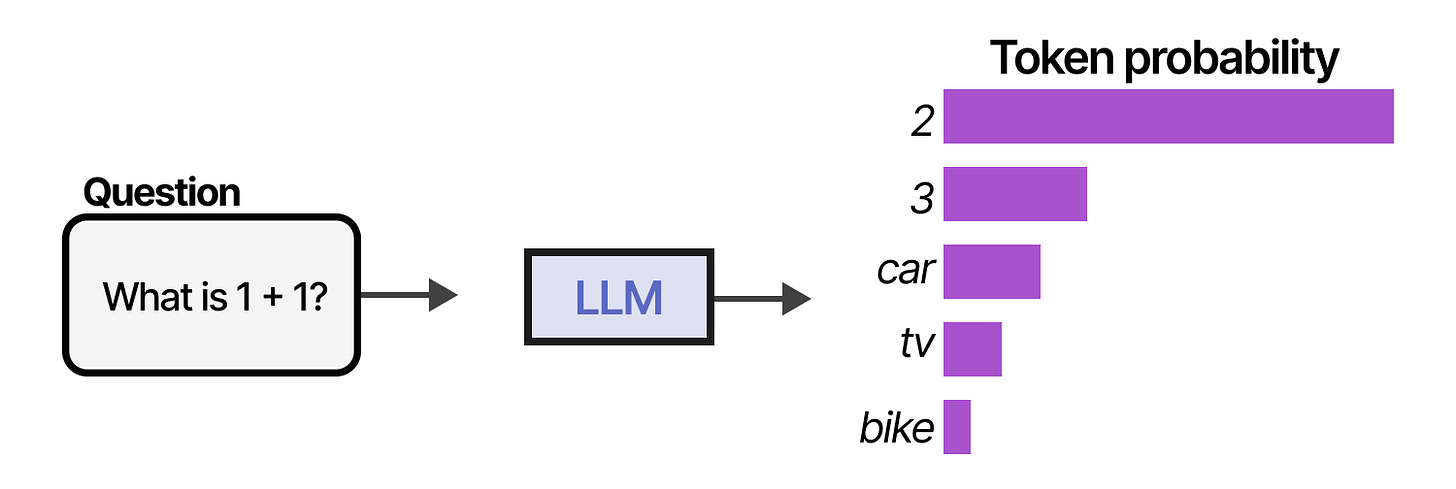
Ebből születtek meg az első nyelvi modellek: a GPT-1, a GPT-2 és a GPT-3. Ezeket a modelleket ma alapmodelleknek nevezzük: az emberi nyelv nyers eloszlását reprezentálják, de a kimeneteik nyersek: nem követnek utasításokat, és nem képesek beszélgetést folytatni. Ma a nyelvi modellek fejlesztésének ezt a kezdeti szakaszát előtanításnak nevezzük, és ez csupán az AI-asszisztens vagy chatbot létrehozásának első lépése - ezt követően még sok minden történik.
A GPT-től a ChatGPT-ig
Hogyan jutottunk el a szavak nyers eloszlásától odáig, hogy úgy beszélgethetünk egy nyelvi modellel, mintha egy emberrel beszélnénk? A válaszhoz vissza kell mennünk 2022 márciusáig, amikor megtörtént az első jelentős áttörés a nyelvi modellek asszisztenssé alakításában: az OpenAI kiadta az InstructGPT-t.
Az InstructGPT volt az első alkalom, amikor egy nyelvi modellt kifejezetten nemcsak az emberi nyelv utánzására, hanem a felhasználó által adott utasítások követésére is tanítottak, amelyeket ma promptoknak nevezünk.
Az eredeti tanulmány bemutatta, hogy egy utótanításnak nevezett technika segítségével testre lehet szabni egy alapmodellt, ebben az esetben a GPT-3-at, hogy segítőkész, utasításokat követő asszisztenssé váljon - ezzel a modell stílusát egy meghatározott személyiség felé alakítva.
A tanulmány három lépést ír le:
- Emberi szövegírók példákat adnak arra, hogy szerintük milyen AI-válaszok elfogadhatók egy adott prompt esetén
- Az AI-kutatók létrehoznak egy jutalmazási modellt, amely megtanulja, hogy az emberek melyik megadott válaszokat részesítik előnyben
- A jutalmazási modell segítségével az AI-kutatók úgy tanítják az LLM-et, hogy nagyszámú generált válasz során maximalizálja a jutalmat
Ez hasonló a pszichológiából ismert pavlovi kondicionáláshoz! A kutatók bizonyos kimenetekért jutalmazzák a modellt, másokért pedig nem, és az ismétlés hatására a modell megtanulja összekapcsolni azt, ami korábban semleges volt - vagyis egy emberek által előnyben részesített válaszkimenetet - a jutalmazási függvény pozitív értékével. Ezt a technikát utasításhangolásnak nevezzük, és ez alakítja át az alapmodellt utasításkövető modellé: olyanná, amely képes beszélgetést folytatni és követni a felhasználó utasításait.
Az utasításhangolás megakadályozza, hogy a nyelvi modellek kisikljanak, elfelejtsék a prompt fontos információit, vagy teljesen irreleváns irányokba induljanak el. Emellett lehetőséget ad az olyan fejlesztőknek, mint az OpenAI és az Anthropic, hogy irányítsák modelljeik viselkedését. A modelleknek például meg kell tagadniuk, hogy elmondják a felhasználónak, hogyan építsen bombát vagy raboljon ki egy bankot, még akkor is, ha a felhasználó ilyen választ szeretne. Utótanítás nélkül nem lenne lehetséges a modellek összehangolása, vagyis az, hogy a nagy nyelvi modelleket segítőkész, ártalmatlan és biztonságos viselkedésre késztessük. Az Anthropic úttörő volt az ilyen jellegű modellviselkedés meghatározásában a Constitutional AI című tanulmányával, amelyben bemutatják, hogyan alkalmaznak utótanítási technikákat olyan AI létrehozására, amely követi az Anthropic alkotmányában meghatározott alapelveket. Végül elméletileg az utasításhangolás kellemesebbé is teszi a modellekkel való beszélgetést. Mivel az emberi értékelők jutalmazzák a modellt a kellemes válaszokért, a modell barátságosabbá válik, és jobb személyiséget alakít ki.
Nincs ingyenebéd: az utótanítás negatív következményei
Az utótanításnak nem csak pozitív oldalai vannak. A kimenetek átalakítása jelentősen befolyásolja a modell viselkedését, és az írását nagyon eltérővé teszi az eredeti alapmodellétől.
Hízelgő egyetértés
Ezt mindenki ismeri, aki használt már nagy nyelvi modelleket. Ha egy LLM-et emberi preferenciák alapján optimalizálnak, az ahhoz vezethet, hogy a modell a helyesség helyett inkább az emberek kedvében próbál járni. Ha ez túl messze megy, az LLM ahelyett, hogy ellentmondana a felhasználó téves meggyőződéseinek, inkább megerősíti azokat. 2025 áprilisában jelentős felháborodást váltott ki az ilyen jellegű hízelgő modellviselkedés, amikor az OpenAI elismerte, hogy a GPT-4o új verziója túlzottan hízelgő és egyetértő volt, még akkor is, amikor ez a felhasználók számára hátrányos következményekkel járt.
A kreativitás és a változatosság csökkenése az AI-kimenetekben
Az utótanítás kevésbé kreatív és kevésbé egyedi válaszokhoz is vezet. Egyes kutatók azt feltételezik, hogy az utótanítás miatt az LLM-ek által írt szöveg laposnak, származtatottnak, egyformának vagy AI-szemétnek tűnik.
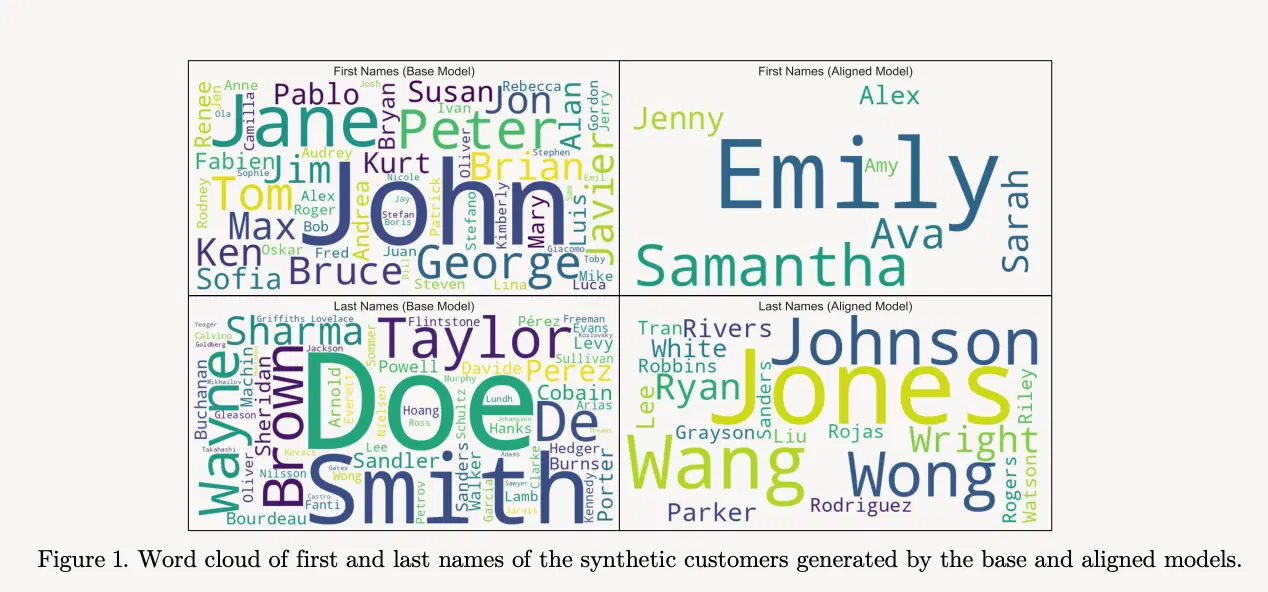
Egy 2024-es tanulmány, a Creativity has Left the Chat, a Meta Llama 2 AI-modelljének utasításkövető és alapváltozata közötti változatosságot hasonlítja össze. A kutatók azt találták, hogy a Llama 2 utasításkövető modellje lényegesen kisebb szemantikai és stilisztikai változatosságot mutatott a kimeneteiben; például történetek szereplőinek kiválasztásakor a Llama 2 utasításkövető változata rendszeresen ugyanolyan korú, nemzetiségű és személyiségtípusú karaktereket választott, sőt még ugyanazokat a neveket is adta nekik. Az alábbiakban az alap- és utasításkövető modellek által választott nevekből készült szófelhő látható.
Kilapított logit-ok és móduszösszeomlás
Ehhez kapcsolódóan az utótanítás úgynevezett kilapított logit-okhoz vezet, amelyek esetében az utótanított LLM-ek determinisztikusan egyetlen következő szót választanak, ahelyett, hogy a lehetséges következő szavak változatos eloszlását állítanák elő.
Elsőre ez nem feltétlenül hangzik rosszul, azonban az úgynevezett módusösszeomláshoz vezet, amely akkor következik be, amikor az LLM-ek már nem állítanak elő kifejezések gazdag választékát, hanem újra és újra ugyanazokat a korlátozott lehetőségeket választják.
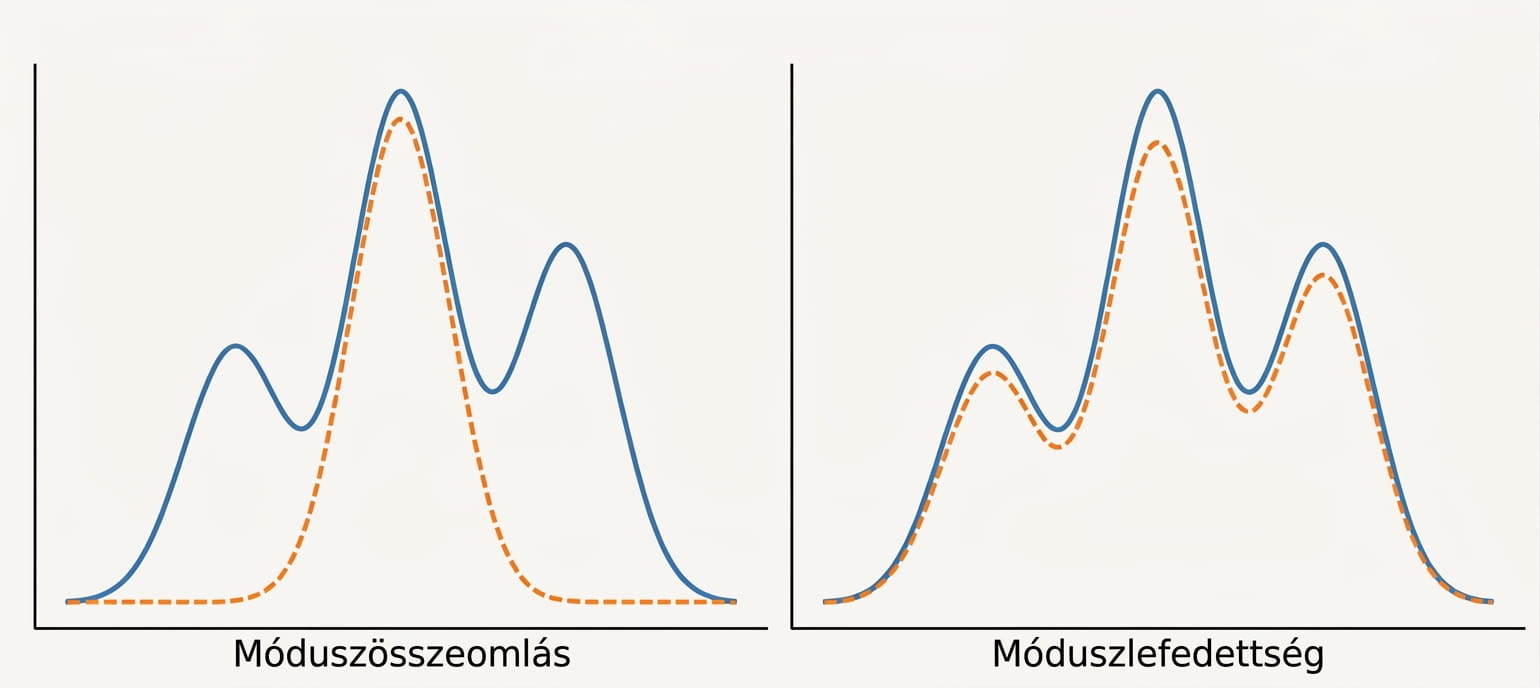
Íme egy vizuális példa a módusösszeomlásra: ha valamit összességében három elterjedt módon lehet megfogalmazni, egy módusösszeomláson átesett LLM alapértelmezés szerint a leggyakoribb megfogalmazási módot választja, ahelyett, hogy a valószínűségét az összes lehetséges megfogalmazás között elosztaná.
Mi köze mindennek a felismerhetőséghez?
Annak, hogy az LLM-eket ilyen módon tanítják, több következménye is van a detektálás szempontjából. Mivel az LLM-eket meghatározott emberi preferenciákra optimalizálják, hajlamosak nagyon jellegzetes személyiségeket felvenni. Ezeknek a személyiségeknek vannak sajátosságaik, visszatérő jellegzetességeik és egyedi tulajdonságaik, amelyeket egy detektáló modell meg tud különböztetni az emberi írástól. A kilapított logitek és a módusösszeomlás azt is jelentik, hogy az összehangolt LLM-ek hajlamosak nagyon következetes döntéseket hozni szöveggeneráláskor, ami azt jelenti, hogy nagy mennyiségű emberi és AI-adat vizsgálatával megtanulhatjuk, mik ezek a döntések.
Ezenfelül a napjainkban fejlesztett LLM-ek a tanításuk során végül saját korábbi kimeneteiket is feldolgozzák, egyszerűen azért, mert az interneten egyre nagyobb mennyiségben jelenik meg AI által generált, alacsony minőségű tartalom. 2024 végére például az új internetes cikkek több mint egyharmada AI által generált; ekkora mennyiségű AI által generált szöveg olyan felerősítő hatáshoz vezet, amelynek eredményeként az új modellek a korábbi, ezeket a szövegeket generáló modellek személyiségjegyeit is átveszik, akár különböző modellcsaládokon keresztül is. Ez az oka annak, hogy sok LLM stílusa hasonlóságokat mutat az eredeti ChatGPT-ével, még akkor is, ha teljesen különböző laboratóriumok készítették őket! Néha ez még szándékosan is történik: széles körben elterjedt feltételezés, hogy kínai laboratóriumok amerikai élvonalbeli modellekből, például a Claude-ból próbálnak „desztillálni” azáltal, hogy azok kimenetein tanítják saját modelljeiket. Ez Claude-szerű személyiséget ad ezeknek a nyelvi modelleknek!
Mindig ennyire felismerhetők lesznek az LLM-ek?
A módusösszeomlás megértése és megoldása a mesterséges intelligencia kutatásának jelenleg is aktív területe. Képesek lesznek-e az LLM-ek egy napon változatosabb kimeneti eloszlásokat létrehozni? Az én álláspontom szerint igen, és már most is léteznek olyan nyelvi modellek, amelyek meglehetősen változatosak: mégpedig az alapmodellek formájában!
Az utótanítás mint paradigma azonban nem fog eltűnni. Az okok, amelyek miatt az LLM-ek következetes döntéseket hoznak és meghatározott preferenciákkal rendelkeznek, a fejlesztőik preferenciáit tükrözik. Kérdezz meg egy kínai nyelvi modellt arról, hogy mi történt 1989-ben a Tienanmen téren, és azonnal észreveheted a fejlesztő preferenciáit! A tény az, hogy utótanítás nélkül nem lehetnek olyan biztonságos és összehangolt nyelvi modelljeink, amelyek segítőkészen és ártalmatlanul viselkednek.
Végső soron az LLM-eket fejlesztő vállalatok fogyasztói termékeket építenek, amelyeknek viselkedési követelményeknek kell megfelelniük: az emberi szövegtérnek vannak olyan területei - például a toxikus tartalmak, a félretájékoztatás stb. -, amelyekből az LLM-vállalatok nem szeretnék, hogy modelljeik mintavételezzenek. Végül az LLM-vállalatok azt is szeretnék optimalizálni, hogy modelljeik kellemes személyiséggel rendelkezzenek - minél szórakoztatóbb az emberek számára a modellel való interakció, annál valószínűbb, hogy egy adott modellt használnak majd a versenytársak modelljei helyett. Ennek megnyilvánulását láthattuk abban is, ahogyan néhány GPT-4o-rajongó reagált arra, hogy az OpenAI megszüntette ezt a modellt.
Ezek a fejlesztői és emberi preferenciák végső soron úgy jelennek meg a modellekben, hogy az összehangolásért, a viselkedés alakításáért és a személyiség optimalizálásáért cserébe leszűkítik az LLM-ek személyiségét és lehetséges kimeneti terét.
Magyar szöveget szeretnél ellenőrizni? A Preds magyar AI-detektor felismeri a ChatGPT, a Claude és a Gemini által írt szövegeket, és mondatonként jelöli a gyanús részeket.