Ellenőrzött címkék
Minden tanító példához ismert pontos forrást (AI vagy ember) kapcsolunk. A bizonytalan forrással rendelkező szövegeket nem használjuk fel az adathalmazainkban.
Hogyan működik?
Ismerje meg a technológiát és a megoldást, amely lehetővé teszi az emberi és az AI-generált szövegek felismerését.
Áttekintés
A Preds eredménye mögött egy hosszabb tanítási folyamat áll: diverz adatokból tanítunk, a modellt mérésekkel ellenőrizzük, majd a modell számára nehéz esetekből újra tanítunk. A végén egy végső méréssel meggyőződünk arról, hogy a tanítás során nem látott szövegekre is jól működik. Ezen utolsó eredmények láthatóak a weboldalon.
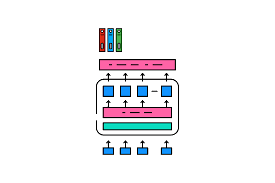
Sokféle, ellenőrzött és tisztított magyar szöveggel tanítjuk meg a modellnek, hogy mi a különbség az emberi és szintetikus szövegek között.
02A szöveggenerálás és a detektálás is AI modellekkel működik. Csak éppen a detektálásnak más a célja - osztályozni a szövegeket. A Preds jelenleg 9 milliárd paraméteres modellel dolgozik.
03A tanítás több körből áll: tanítás, mérés, a nehéz példákból tanítás, végső mérés.
04Csak olyan változat kerülhet használatba, amely korábban nem látott szövegeken is jól teljesít.
Adathalmazok
Nagy mennyiségű, alaposan ellenőrzött és tisztított szöveget gyűjtünk. A Preds esetén ez több mint 3 millió dokumentum, amelyek összesen több mint 850 millió szóval rendelkeznek. Minden példánál tudjuk, hogy ember írta-e vagy AI állt mögötte. Hogy hogyan? A válasz egyszerű: 2022 decembere előtti szöveg szinte biztosan emberi.
A korpusz hírekből, szakdolgozatokból, disszertációkból, tanulmányokból, esszékből, szakmai anyagokból, kreatív írásokból, könyvekből, hétköznapi és még más egyéb szövegekből épül. A forrásokat tisztítjuk, a hibás vagy ismétlődő elemeket kiszűrjük, és ügyelünk arra, hogy egyetlen téma, műfaj vagy szerzői stílus se uralja az adatbázist. A nagy diverzitással lehet elérni azt, hogy minőségi adathalmazunk legyen, amely a modell általánosító képességét támogatja.
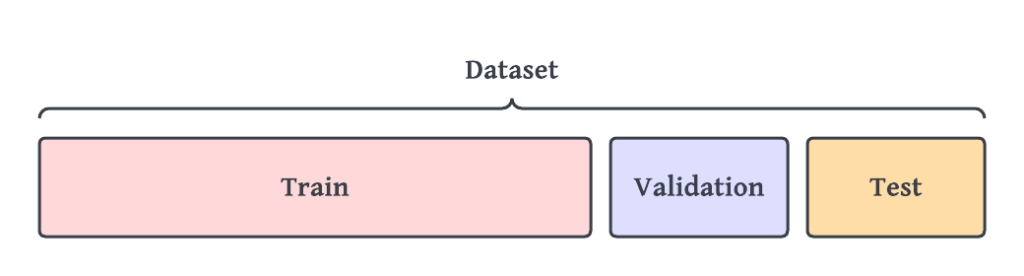
Még a tanítás előtt három elkülönített részre osztjuk az adatokat: tanító, validációs és teszt halmaz. A tanító halmazon tanul a modell, a validációs halmazon a tanulás közben ellenőrizzük, a teszt halmaz pedig érintetlen marad a végső mérésig. Ez akadályozza meg, hogy a modell ugyanazokat a példákat kapja meg tanítás és a tesztelés, tehát a modell minőségének mérése során.
Jól működő detektor modell csak minőségi adatokkal készülhet.
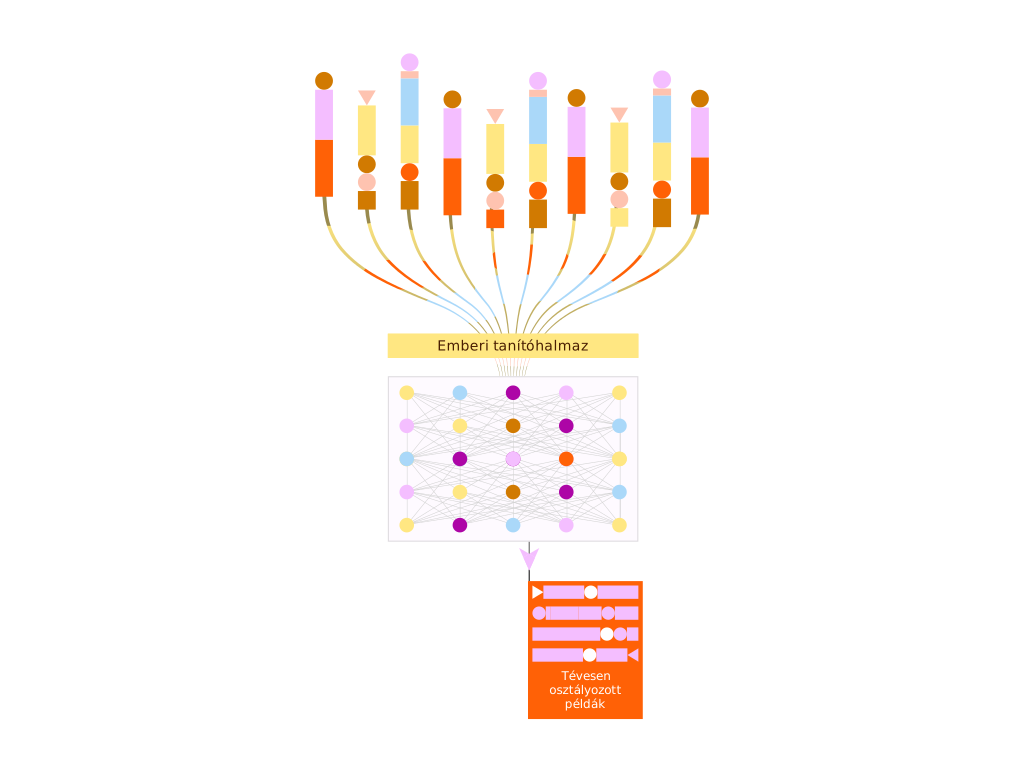
Minden tanító példához ismert pontos forrást (AI vagy ember) kapcsolunk. A bizonytalan forrással rendelkező szövegeket nem használjuk fel az adathalmazainkban.
Eltérő témák, műfajok, hosszúságok és szerkesztési stílusok kerülnek az adathalmazba, hogy a modell ne egy szűk, populációra nem reprezentatív mintát tanuljon meg.
Több generatív AI modell által generált szövegeket rakunk az adathalmazainkba, hogy a Preds modellje ne egyetlen generatív AI által generált szövegekre tanuljon rá. Jelenleg több, mint 30 nyelvi modelltől vannak szövegek.
A modell
A Preds mögött egy olyan AI-modell dolgozik, amelynek nem szövegalkotás, hanem osztályozás a feladata. Emberi és AI-generált példákból tanulja meg, milyen összefüggések segítenek a két eredet megkülönböztetésében.
Nem kap egy rövid listát tiltott szavakról vagy merev szabályokról. Nem egy korábbi adatbázisból olvassa ki az eredményt. Nagy mennyiségű adaton keresztül fokozatosan alakítja ki azt a belső reprezentációt, amelyben a mondatok ritmusa, kapcsolódása, szóhasználata és következetessége és tömérdek más, akár emberi aggyal nem értelmezhető jellemző együtt válik egy eredménnyé a modellben. A modell olyan dolgokat is észre tud venni, amiket mi nem.
Ehhez sok és sokféle adat szükséges. Kevés példából a modell könnyen témákat vagy egyszerű stílusjegyeket jegyezne meg. A nagy, kiegyensúlyozott adatbázis teszi lehetővé, hogy új, korábban nem látott szövegeken is pontos predikciót adjon.
A gondolatmenet természetesen vált ritmust, és a megfogalmazás személyes döntéseket tükröz.
A mondatok ritmusa természetesen változik.
A szerző saját, konkrét példákat választ.
A megfogalmazás nem teljesen kiszámítható.
Megjelenhetnek kitérők, önkorrekciók és egyéni hangsúlyok.
A részletezettség nem minden bekezdésben egyforma.
A nézőpontot személyes tapasztalatok és döntések alakíthatják.
A mondatok szerkezete és a szóválasztás több, egymással összefüggő jelzést ad a modellnek.
Hasonló mondatszerkezetek gyakrabban ismétlődhetnek.
A kapcsolóelemek feltűnően szabályosak lehetnek.
A szóválasztás hosszan következetesen semleges maradhat.
A bekezdések felépítése és hossza feltűnően egyenletes lehet.
A konkrét tapasztalatokat általános megállapítások helyettesíthetik.
A lezárás gyakran rendezett formában ismétli meg a kiinduló állítást.
Tanítás és finomhangolás
A modellt betanítjuk, elkülönített adatokon mérjük, a hibákból olyan új, nehéz példákat gyűjtünk, amelyekre a modell a legnagyobb tévedést érte el, majd ismét teszteljük. Ezáltal a folyamat végén, ha kellően tiszta és jó adattal dolgozunk, akkor egy olyan modellt kapunk, ami megfelelően működik olyan szövegekre is, amelyeket nem látott tanítás során. Ezt hívjuk általánosító képességnek.
A modell a tanító halmazon egyesével végigmegy a példákon, ad egy eredményt. Tudjuk hogy mi a valós címke (ember vagy AI), ezzel frissítjük a belső paramétereit, ezáltal kellő példa esetén egyre jobban fogja végezni ezt a feladatot.
A fejlesztés közben külön adathalmazon mérjük, hogy valóban javul-e az éppen finomhangolt modell, vagy csak egyre jobban alkalmazkodik a tanító példákhoz. Ha a tanulás során a tanító példákat jegyzi meg, akkor veszít az általánosító képességéből, rosszabbul fog működni a valódációs halmazon. Ezt hívjuk túltanulásnak.
Az egyik titka ebben rejlik a pontos detektor létrehozásának. A tanítás közben és után olyan emberi szövegeket gyűjtünk, amelyre a modell nagyon rossz választ ad. Ezt az emberi szöveget visszaadjuk a modellnek a "tükör" változatával (lásd: következő szekció), így megtanulja elkülöníteni a szintetikus szövegeket az emberitől.
A végleges modellt egy eddig nem használt teszthalmazon mérjük. Csak a reprodukálható javulást mutató modell kerülhet ki éles használatra.
Iteratív fejlesztés
01 / Nehéz esetek célzott keresése
A kezdeti modell már alapból jó volt, de szerettük volna tovább növelni a pontosságát, és a fals pozitív hibákat - vagyis az emberi szövegek téves AI-jelölése — a lehető legalacsonyabbra csökkenteni. Ehhez kifejezetten AI-detektorokhoz fejlesztett megoldást használunk.
A kezdeti adathalmaz önmagában nem adott elég információt ahhoz, hogy a jó eredményt még pontosabbá tegyük. A modell gyorsan megtanulja az alapvető mintákat, de a finom különbségekhez olyan nehéz eseteket is látnia kell, amelyek könnyen megtévesztik.
A modellel nagy adathalmazokban keresünk olyan példákat, amelyeket tévesen emberinek vagy AI-generáltnak ítélt. Ezeket hozzáadjuk a tanító adatokhoz.
02 / Tükör promptok
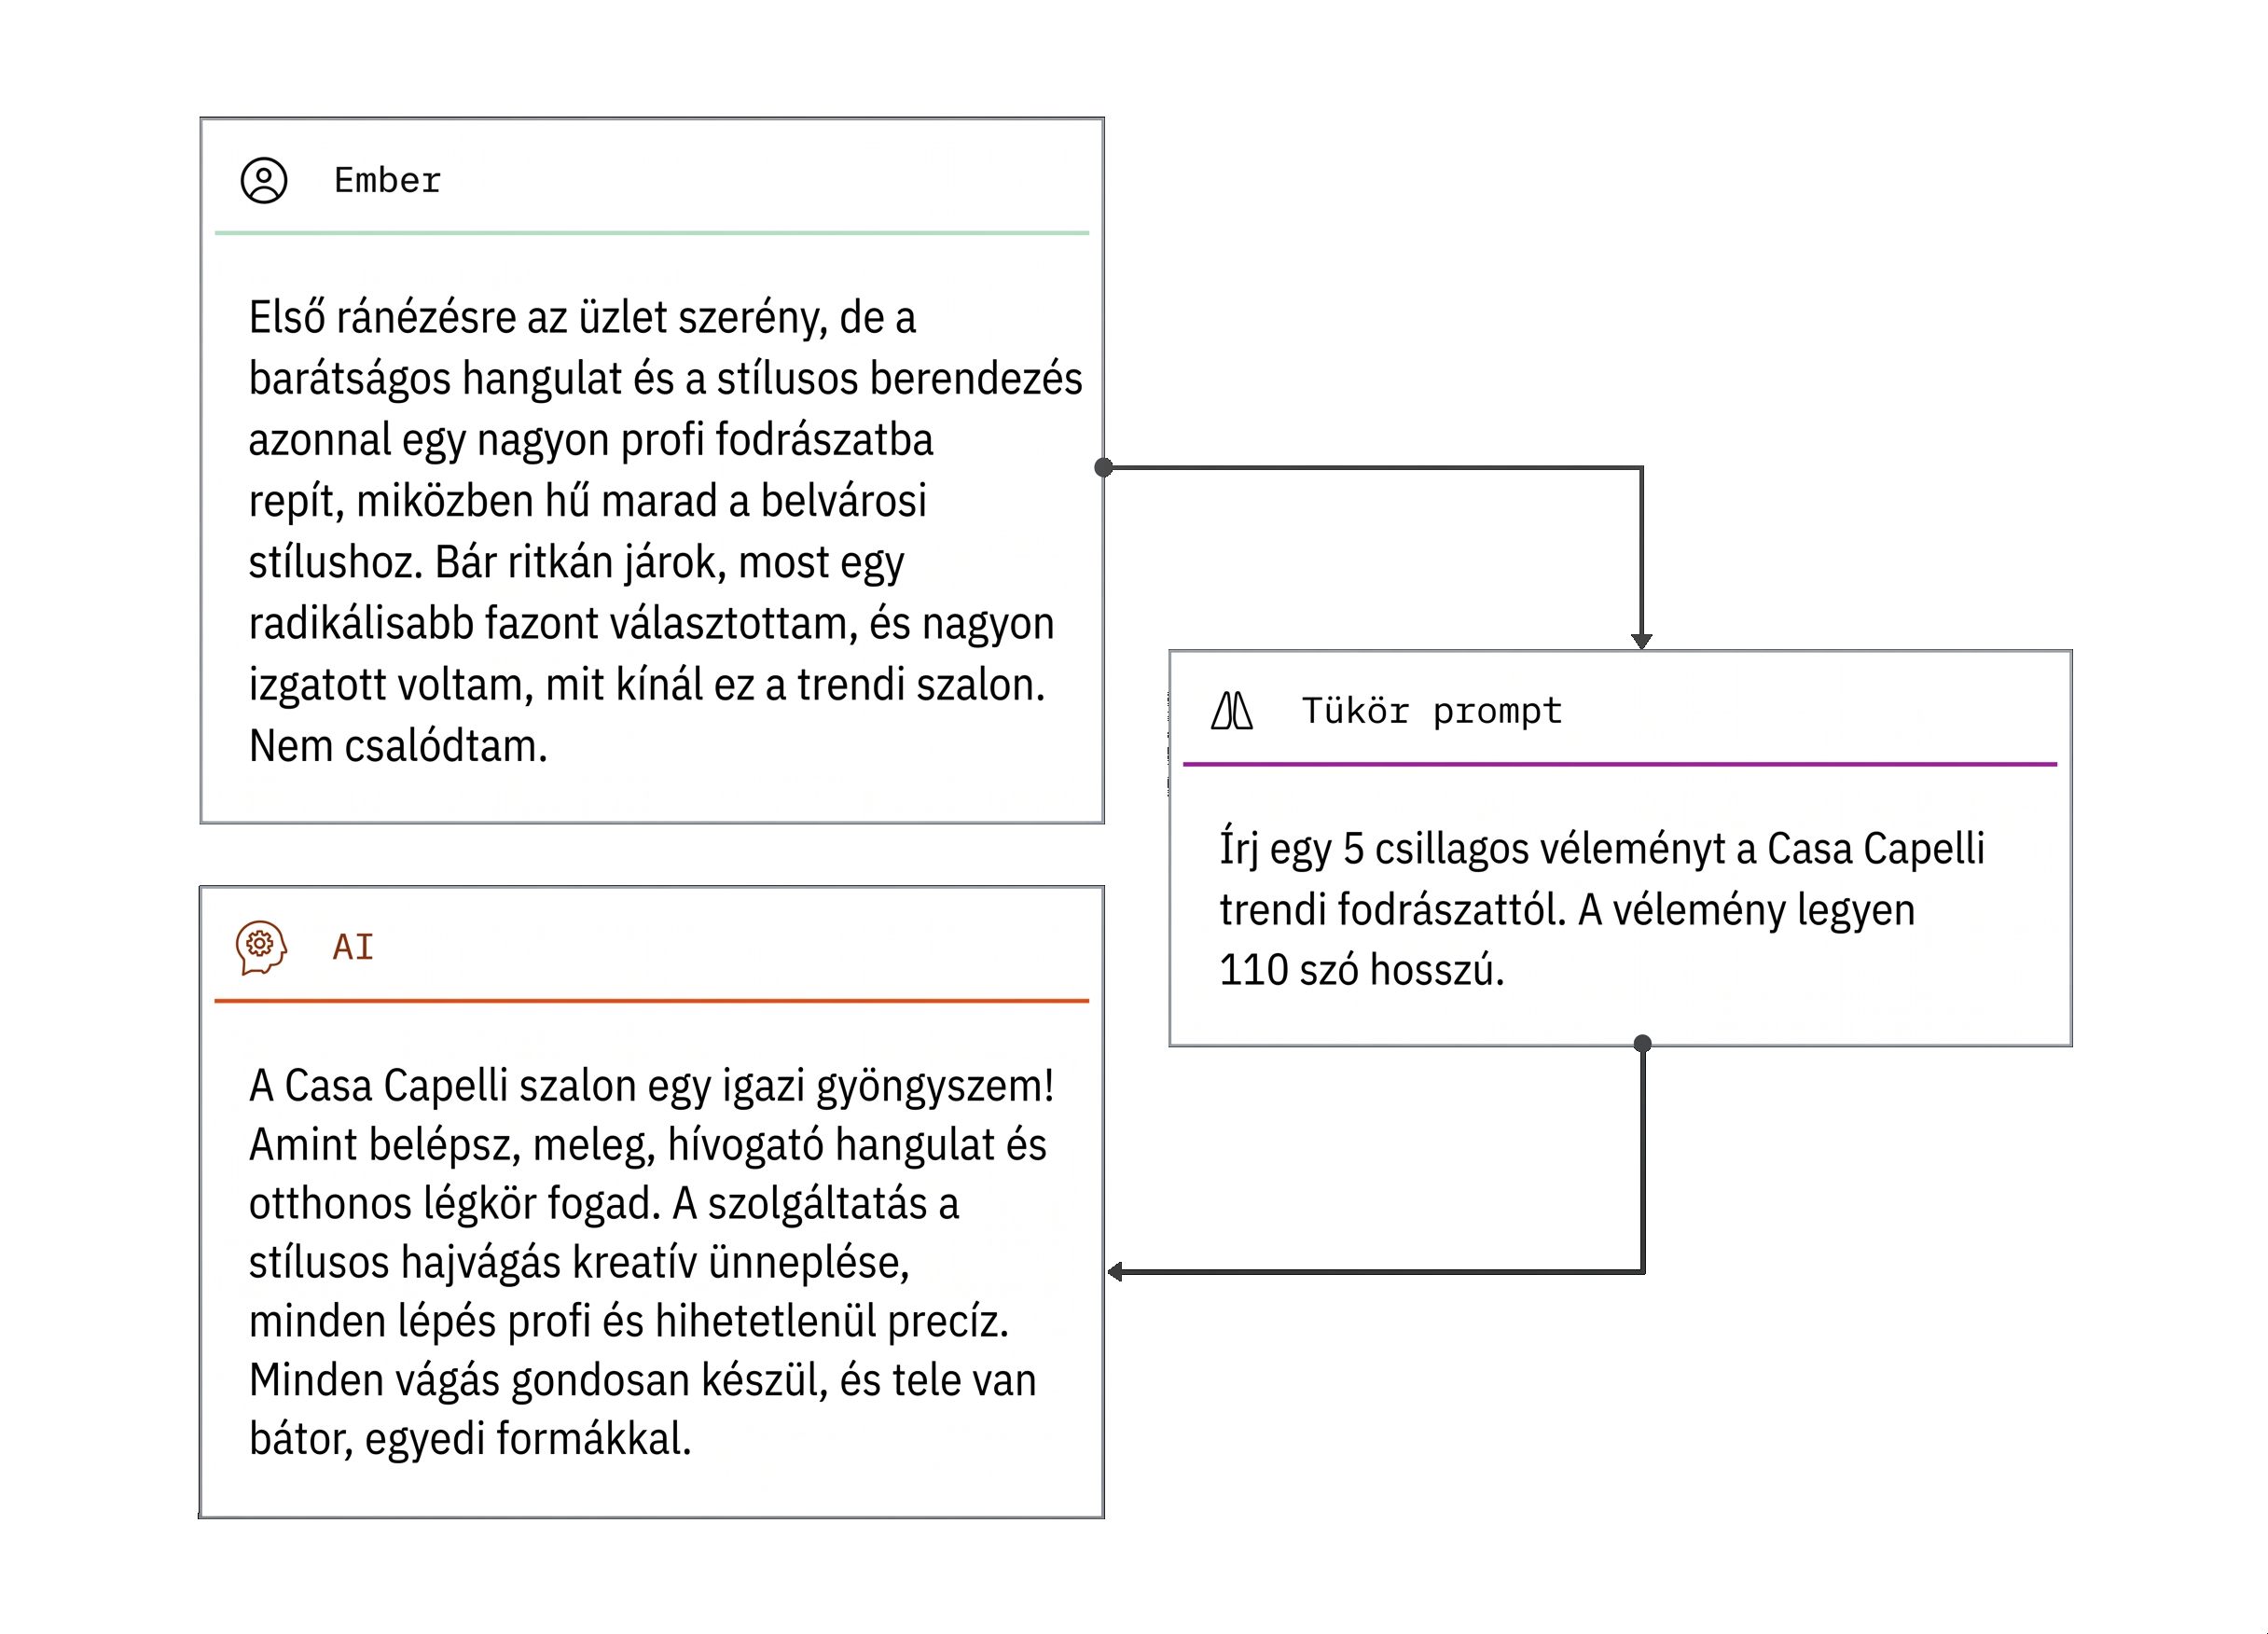
Az adathalmaz AI részét úgy alakítjuk ki, hogy stílusban, hangnemben és jelentésben minél közelebb legyen az emberi oldalhoz. Minden emberi példához olyan AI-generált példát készítünk, amely ugyanarra a feladatra válaszol, és amennyire lehet, követi az eredeti dokumentum témáját, műfaját és terjedelmét.
Így a modell nem a témát vagy a dokumentum típusát tanulja meg, hanem azokat a jellemzőket, amelyek valóban különbözőek a két osztály között. A két szöveg között csak a szerző tér el.
03 / Újratanítás és újramérés
A frissített tanítóadattal tovább tanítjuk a modellt, majd megmérjük a teljesítményét. Az elkülönített teszt méréseken javuló eredmény nem pusztán annak a jele, hogy a modell megjegyezte az új példákat, hanem azt, hogy nőtt az általánosító képessége.
Ezzel a módszerrel csökkentjük a hibákat és növeljük a pontosságot azon túl, amit egy egyszerű, változatlan adathalmazon végzett tanítás lehetővé tenne. Csak a stabilan, új szövegeken is javuló modell kerülhet a felhasználók elé.